分析データの粒度はより細かく データ分析講座(その164)

更新日

投稿日

データ分析


◆ 分析は最終的かつ不可逆的なもの

 蓄積され続けてはいるけど、人手にあまり触れられていないデータの中には、データの粒度がバラバラなケースが多々みられます。そのようなデータを相手に集計や分析を行うと非常に苦労します。ちなみに、データの粒度とはデータの細かさの程度をいいます。分かりやすくお話すると時間やカテゴリー、エリアなどです。例えば時間の粒度がバラバラとは、あるデータは日単位で、あるデータは月単位であるということです。

 カテゴリーの粒度がバラバラとは、エリアや時期によってデータとして蓄積されているカテゴリーが異なったり(ある時期は大カテゴリーまでのデータしかない、など)、カテゴリーの分け方(考え方)が異なるということです。

 今回は「分析は最終的かつ不可逆的なので、データの粒度はより細かく」というお話しをします。

【目次】

  1. 加工は「不可逆的」
    (1)粗い粒度を細かくできない
    (2)モデルを構築した時、使用した学習データは、モデルからは分からない
    (3)覆水盆に返らず
  2. データの粒度はより細かく蓄積しておこう
  3. 今回のまとめ


1. 加工は「不可逆的」

 不可逆的とは、加工する(手を加える)と元に戻せない性質のことを意味します。例えば、工場で物を生産するとき、機械などで加工しますが、一度材料などに手を加えると元の状態に戻すことができなくなります。データの集計や分析なども同様です。

(1)粗い粒度を細かくできない

 1日単位のデータを1ケ月単位に集計するなど、細かい粒度のデータを粗くすることは可能です。しかし逆は非常に難しくなります。要するに、粗い粒度を細かくできないのです。

(2)モデルを構築した時、使用した学習データは、モデルからは分からない

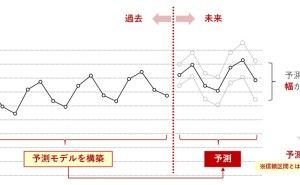
 データ分析・活用をビジネスで実施しようとする時、異常検知や予測モデルなどを構築することはあります。これらモデルを構築するためにはデータが必要になります。そのようなデータを、学習データといいます。当然ですが、モデルを構築した時に使用した学習データは、モデルからは分かりません。

(3)覆水盆に返らず

 データ分析も最終的かつ不可逆的なため、後から粒度の粗いデータを細かくできないし、構築されたモデルから学習データを作ることはできません。要するに「覆水盆に返らず」です。もし、データの粒度が粗い状態で蓄積されていたら最終的かつ不可逆的と諦(あきら)め、その範囲でどうにかして、データ分析・活用をしなければなりません。

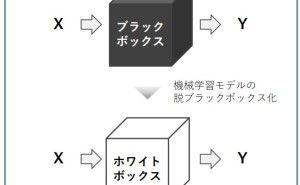
 ブラックボックス化された異常検知や予測モデルなどを使うのであれば最終的かつ不可逆的と諦め、その状態でデータ分析・活用をしなければなりません。つまり、取り返しがつかないということです。ここで悩んでも仕方がないので、現状でどうにかする必要があります。さらに、今後悩まないように、データ分析も最終的かつ不可逆的であることを前提に、データ分析・活用を考えていく必要はあります。


2. データの粒度はより細かく蓄積しておこう

 可能ならば、データの粒度はより細かく蓄積しておいたほうがいいでしょう。

 今不必要な粒度でも、将来必要な粒度になることはあります。また、利用している数理モデルを構築した時の学習データなども残しておきましょう。その時学習データだけでなく、どのように学習させたかという条件設定や、そこに至るまでのフローなども残しておいたほうがいいでしょう。残念なことに、数理モデルを構築したときの学習データと思われるもので、数理モデルを再構築したのに再現できない、ということがたまにあります。


3. 今回のまとめ

 今回は「データの粒度はより細かく、なぜならばデータ分析は最終的かつ不可逆的だから」というお話しをしました。

 それなりのデータ分析をしたことのないデータの場合、データの粒度がバラバラで苦労することがあります。データの粒度とは、文字通りデータの細かさの程度をいい、時間やカテゴリー、エリアなどです。例えば、1日単位のデータを、...
データ分析


◆ 分析は最終的かつ不可逆的なもの

 蓄積され続けてはいるけど、人手にあまり触れられていないデータの中には、データの粒度がバラバラなケースが多々みられます。そのようなデータを相手に集計や分析を行うと非常に苦労します。ちなみに、データの粒度とはデータの細かさの程度をいいます。分かりやすくお話すると時間やカテゴリー、エリアなどです。例えば時間の粒度がバラバラとは、あるデータは日単位で、あるデータは月単位であるということです。

 カテゴリーの粒度がバラバラとは、エリアや時期によってデータとして蓄積されているカテゴリーが異なったり(ある時期は大カテゴリーまでのデータしかない、など)、カテゴリーの分け方(考え方)が異なるということです。

 今回は「分析は最終的かつ不可逆的なので、データの粒度はより細かく」というお話しをします。

【目次】

  1. 加工は「不可逆的」
    (1)粗い粒度を細かくできない
    (2)モデルを構築した時、使用した学習データは、モデルからは分からない
    (3)覆水盆に返らず
  2. データの粒度はより細かく蓄積しておこう
  3. 今回のまとめ


1. 加工は「不可逆的」

 不可逆的とは、加工する(手を加える)と元に戻せない性質のことを意味します。例えば、工場で物を生産するとき、機械などで加工しますが、一度材料などに手を加えると元の状態に戻すことができなくなります。データの集計や分析なども同様です。

(1)粗い粒度を細かくできない

 1日単位のデータを1ケ月単位に集計するなど、細かい粒度のデータを粗くすることは可能です。しかし逆は非常に難しくなります。要するに、粗い粒度を細かくできないのです。

(2)モデルを構築した時、使用した学習データは、モデルからは分からない

 データ分析・活用をビジネスで実施しようとする時、異常検知や予測モデルなどを構築することはあります。これらモデルを構築するためにはデータが必要になります。そのようなデータを、学習データといいます。当然ですが、モデルを構築した時に使用した学習データは、モデルからは分かりません。

(3)覆水盆に返らず

 データ分析も最終的かつ不可逆的なため、後から粒度の粗いデータを細かくできないし、構築されたモデルから学習データを作ることはできません。要するに「覆水盆に返らず」です。もし、データの粒度が粗い状態で蓄積されていたら最終的かつ不可逆的と諦(あきら)め、その範囲でどうにかして、データ分析・活用をしなければなりません。

 ブラックボックス化された異常検知や予測モデルなどを使うのであれば最終的かつ不可逆的と諦め、その状態でデータ分析・活用をしなければなりません。つまり、取り返しがつかないということです。ここで悩んでも仕方がないので、現状でどうにかする必要があります。さらに、今後悩まないように、データ分析も最終的かつ不可逆的であることを前提に、データ分析・活用を考えていく必要はあります。


2. データの粒度はより細かく蓄積しておこう

 可能ならば、データの粒度はより細かく蓄積しておいたほうがいいでしょう。

 今不必要な粒度でも、将来必要な粒度になることはあります。また、利用している数理モデルを構築した時の学習データなども残しておきましょう。その時学習データだけでなく、どのように学習させたかという条件設定や、そこに至るまでのフローなども残しておいたほうがいいでしょう。残念なことに、数理モデルを構築したときの学習データと思われるもので、数理モデルを再構築したのに再現できない、ということがたまにあります。


3. 今回のまとめ

 今回は「データの粒度はより細かく、なぜならばデータ分析は最終的かつ不可逆的だから」というお話しをしました。

 それなりのデータ分析をしたことのないデータの場合、データの粒度がバラバラで苦労することがあります。データの粒度とは、文字通りデータの細かさの程度をいい、時間やカテゴリー、エリアなどです。例えば、1日単位のデータを、1ケ月単位に集計するなど、細かい粒度のデータを粗くすることは可能です。データ分析は最終的かつ不可逆的なため、集計したものや構築したモデルから元データを得ることはできません。

 実際に、1ケ月単位のデータを、1日単位のデータにすることは、非常に無理があります。もし、データの粒度が粗い状態で蓄積されていたら最終的かつ不可逆的と諦め、その範囲でどうにかし、データ分析・活用をしなければなりません。ブラックボックス化された異常検知や予測モデルなどを使うのであれば最終的かつ不可逆的と諦め、ブラックボックス化された状態でデータ分析・活用をしなければなりませんので、その現状でどうにかする必要があります。

 さらに今後悩まないよう、データ分析も最終的かつ不可逆的であることを前提に、データ分析・活用を考えていく必要があります。可能ならば、データの粒度はより細かく蓄積しておいたほうがいいでしょう。


 次回に続きます。

   続きを読むには・・・


この記事の著者

高橋 威知郎

データネクロマンサー/データ分析・活用コンサルタント (埋もれたデータに花を咲かせる、データ分析界の花咲じじい。それほど年齢は重ねてないけど)

データネクロマンサー/データ分析・活用コンサルタント (埋もれたデータに花を咲かせる、データ分析界の花咲じじい。それほど年齢は重ねてないけど)


「情報マネジメント一般」の他のキーワード解説記事

もっと見る
現場業務改善を目指すITシステム導入のステップガイド

  1. ITシステム導入の課題 1.1  ITシステム導入の重要性 製造業において、ITシステムの導入は業務効率の向上や生...
  1. ITシステム導入の課題 1.1  ITシステム導入の重要性 製造業において、ITシステムの導入は業務効率の向上や生...

早わかりEDA:Electronic Design Automation

  集積回路、プリント回路基板設計と検証に使われるワークフロー、アプリケーション、手法は、CAE (Computer-Aided Engi...
  集積回路、プリント回路基板設計と検証に使われるワークフロー、アプリケーション、手法は、CAE (Computer-Aided Engi...

データパイプラインの設計と活用ガイド、収集・統合・分析・意思決定への道のりを解説

【目次】 現代社会は、情報技術の進化とデジタルトランスフォーメーション(DX)の波により、未曾有の「データ駆動型社会」へと変貌を遂げ...
【目次】 現代社会は、情報技術の進化とデジタルトランスフォーメーション(DX)の波により、未曾有の「データ駆動型社会」へと変貌を遂げ...

「情報マネジメント一般」の活用事例

もっと見る
‐技術開発の目標について 第2回‐  製品・技術開発力強化策の事例(その16)

 技術開発の目標を解説する以下の項目4点について、前回は、1と2を解説しましたので、今回は、第2回として、3と4を記述します。          1....

 技術開発の目標を解説する以下の項目4点について、前回は、1と2を解説しましたので、今回は、第2回として、3と4を記述します。          1....


‐販路開拓に関する問題事例‐ 製品・技術開発力強化策の事例(その19)

 前回の事例その18に続いて解説します。多額の資金と労力を費やして開発した知的財産をどのように活用して販路開拓に結びつけるのか、大変重要な問題ですが、販売...

 前回の事例その18に続いて解説します。多額の資金と労力を費やして開発した知的財産をどのように活用して販路開拓に結びつけるのか、大変重要な問題ですが、販売...


たかがWord、されどWord

 マイクロソフトOfficeはどこでも使われているので、ITリテラシーとしてWordを使えることが求められます。『 Wordが使える 』と言っても、そのレ...

 マイクロソフトOfficeはどこでも使われているので、ITリテラシーとしてWordを使えることが求められます。『 Wordが使える 』と言っても、そのレ...