機械学習の世界では、データの前処理がモデルの精度や性能に大きな影響を与えます。その中でも、特徴量スケーリング(Feature Scaling)は非常に重要なステップです。特徴量スケーリングとは、データの範囲や分布を統一することで、アルゴリズムの性能を最適化する手法です。今回は、特徴量スケーリングの重要性、具体的な手法、そして実際の使用例について解説します。
1.はじめに
機械学習モデルの構築において、データの前処理は非常に重要です。その中でも特徴量スケーリングは、モデルの性能を向上させるための基本的な手法です。スケーリングを行わないと、異なるスケールを持つ特徴量がモデルに悪影響を及ぼし、結果として精度が低下することがあります。特に勾配降下法を用いるアルゴリズムや距離計算に基づくアルゴリズム(例えば、k-近傍法やSVM)では、スケーリングが欠かせません。特徴量スケーリングが必要な理由は以下の通りです。
モデルの安定性の向上
スケールの異なる特徴量があると、モデルは大きなスケールの特徴量に引きずられてしまい、学習が偏る可能性があります。スケーリングにより、すべての特徴量が同等に扱われるようになります。
計算効率の向上
スケーリングにより、アルゴリズムがより迅速に収束することが期待できます。特に勾配降下法などでは、収束速度が大幅に改善されます。
アルゴリズム特性の維持
多くの機械学習アルゴリズムは、特徴量のスケールに敏感です。例えば、距離に基づくアルゴリズムは、特徴量のスケールが異なると誤った結果を導きかねません。
それぞれについて説明を加えます。
2.モデルの安定性の向上
特徴量スケーリングは、機械学習モデルの精度を向上させるための重要な前処理の1つです。
(1)スケールに敏感なアルゴリズム
多くの機械学習アルゴリズムは、特徴量のスケールに対して非常に敏感です。サポートベクターマシン(SVM)やk近傍法(k-NN)も、特徴量のスケールに非常に敏感です。SVMでは、スケールの異なる特徴量が決定境界に影響を与え、k-NNでは距離計算においてスケールが異なる特徴量が結果を左右するため、スケーリングが必要です。ニューラルネットワークも、入力データのスケールに非常に敏感です。入力データのスケールが大きく異なると、勾配降下法による学習プロセスが非効率になり、収束が遅くなるだけでなく、局所的な最適解に陥りやすくなります。
(2)学習の安定化
スケーリングを行うことで、学習が安定し、モデルの収束速度が向上します。勾配降下法では、誤差を最小化するために各特徴量に対する勾配が計算されます。スケールが統一されていないと、勾配が大きく異なり、モデルのパラメータが適切に更新されません。スケーリングにより、勾配が均一化され、効率的なパラメータ更新が可能になります。大きなスケールの特徴量が存在すると、計算が不安定になる可能性があります。
特に、ニューラルネットワークのような深層学習モデルでは、数値的な不安定性がモデルの性能に大きな悪影響を与えることがあります。スケーリングによって、このような数値的不安定性が軽減されます。
3.計算効率の向上
特徴量スケーリングは、機械学習アルゴリズムの計算効率を向上させるための重要なステップです。特に、勾配降下法(Gradient Descent)を用いるアルゴリズムにおいて、その効果は顕著です。
(1)勾配降下法の効率化
勾配降下法は、多くの機械学習アルゴリズムで使用される最適化手法です。この手法は、モデルの誤差(損失関数)を最小化するために、各特徴量のパラメータを反復的に更新していきます。しかし、特徴量のスケールが異なる場合、以下の問題が発生します。
不均一な勾配
特徴量のスケールが大きく異なると、勾配の大きさも異なります。これは、パラメータの更新量が不均一になり、学習が非効率になる原因となります。具体的には、大きなスケールの特徴量に対する勾配は大きく、小さなスケールの特徴量に対する勾配が小さくなるため、勾配降下法のステップサイズが適切に設定されない場合、収束速度が遅くなります。
長い収束時間
スケールの異なる特徴量が混在すると、最適解に到達するまでの反復回数が増加します。特に、学習率(ステップサイズ)が適切に設定されていない場合、収束に非常に長い時間がかかることがあります。
(2)特徴量スケーリングの効果
特徴量スケーリングを行うことで、以下のような効果が得られます。
勾配の均一化
スケーリングにより、すべての特徴量が同じ範囲に収まるため、勾配の大きさも均一化されます。これにより、パラメータの更新が均等に行われ、効率的な学習が可能になります。
適切なステップサイズ
スケーリングを行うことで、勾配降下法のステップサイズが適切に設定されるため、収束速度が大幅に改善されます。結果として、最適解に迅速に到達することができます。
4.アルゴリズム特性に与える影響
特徴量スケーリングは、機械学習アルゴリズムの特性にも大きな影響を与えます。特に、距離に基づくアルゴリズムや線形モデルにおいて、その影響は顕著です。ここでは、具体的なアルゴリズムを例に挙げて、特徴量スケーリングがどのようにアルゴリズムの性能を向上させるかを説明します。
(1)距離に基づくアルゴリズム
距離に基づくアルゴリズムは、特徴量間の距離を計算することで予測や分類を行います。以下のアルゴリズムがその代表例です。
k-近傍法(k-NN)
k-近傍法は、データポイント間の距離を計算し、最も近いk個のポイントの多数決や平均値を用いて予測を行います。特徴量のスケールが異なると、大きなスケールを持つ特徴量が距離計算において支配的になり、小さなスケールの特徴量が無視される可能性があります。スケーリングを行うこと...
機械学習の世界では、データの前処理がモデルの精度や性能に大きな影響を与えます。その中でも、特徴量スケーリング(Feature Scaling)は非常に重要なステップです。特徴量スケーリングとは、データの範囲や分布を統一することで、アルゴリズムの性能を最適化する手法です。今回は、特徴量スケーリングの重要性、具体的な手法、そして実際の使用例について解説します。
1.はじめに
機械学習モデルの構築において、データの前処理は非常に重要です。その中でも特徴量スケーリングは、モデルの性能を向上させるための基本的な手法です。スケーリングを行わないと、異なるスケールを持つ特徴量がモデルに悪影響を及ぼし、結果として精度が低下することがあります。特に勾配降下法を用いるアルゴリズムや距離計算に基づくアルゴリズム(例えば、k-近傍法やSVM)では、スケーリングが欠かせません。特徴量スケーリングが必要な理由は以下の通りです。
モデルの安定性の向上
スケールの異なる特徴量があると、モデルは大きなスケールの特徴量に引きずられてしまい、学習が偏る可能性があります。スケーリングにより、すべての特徴量が同等に扱われるようになります。
計算効率の向上
スケーリングにより、アルゴリズムがより迅速に収束することが期待できます。特に勾配降下法などでは、収束速度が大幅に改善されます。
アルゴリズム特性の維持
多くの機械学習アルゴリズムは、特徴量のスケールに敏感です。例えば、距離に基づくアルゴリズムは、特徴量のスケールが異なると誤った結果を導きかねません。
それぞれについて説明を加えます。
2.モデルの安定性の向上
特徴量スケーリングは、機械学習モデルの精度を向上させるための重要な前処理の1つです。
(1)スケールに敏感なアルゴリズム
多くの機械学習アルゴリズムは、特徴量のスケールに対して非常に敏感です。サポートベクターマシン(SVM)やk近傍法(k-NN)も、特徴量のスケールに非常に敏感です。SVMでは、スケールの異なる特徴量が決定境界に影響を与え、k-NNでは距離計算においてスケールが異なる特徴量が結果を左右するため、スケーリングが必要です。ニューラルネットワークも、入力データのスケールに非常に敏感です。入力データのスケールが大きく異なると、勾配降下法による学習プロセスが非効率になり、収束が遅くなるだけでなく、局所的な最適解に陥りやすくなります。
(2)学習の安定化
スケーリングを行うことで、学習が安定し、モデルの収束速度が向上します。勾配降下法では、誤差を最小化するために各特徴量に対する勾配が計算されます。スケールが統一されていないと、勾配が大きく異なり、モデルのパラメータが適切に更新されません。スケーリングにより、勾配が均一化され、効率的なパラメータ更新が可能になります。大きなスケールの特徴量が存在すると、計算が不安定になる可能性があります。
特に、ニューラルネットワークのような深層学習モデルでは、数値的な不安定性がモデルの性能に大きな悪影響を与えることがあります。スケーリングによって、このような数値的不安定性が軽減されます。
3.計算効率の向上
特徴量スケーリングは、機械学習アルゴリズムの計算効率を向上させるための重要なステップです。特に、勾配降下法(Gradient Descent)を用いるアルゴリズムにおいて、その効果は顕著です。
(1)勾配降下法の効率化
勾配降下法は、多くの機械学習アルゴリズムで使用される最適化手法です。この手法は、モデルの誤差(損失関数)を最小化するために、各特徴量のパラメータを反復的に更新していきます。しかし、特徴量のスケールが異なる場合、以下の問題が発生します。
不均一な勾配
特徴量のスケールが大きく異なると、勾配の大きさも異なります。これは、パラメータの更新量が不均一になり、学習が非効率になる原因となります。具体的には、大きなスケールの特徴量に対する勾配は大きく、小さなスケールの特徴量に対する勾配が小さくなるため、勾配降下法のステップサイズが適切に設定されない場合、収束速度が遅くなります。
長い収束時間
スケールの異なる特徴量が混在すると、最適解に到達するまでの反復回数が増加します。特に、学習率(ステップサイズ)が適切に設定されていない場合、収束に非常に長い時間がかかることがあります。
(2)特徴量スケーリングの効果
特徴量スケーリングを行うことで、以下のような効果が得られます。
勾配の均一化
スケーリングにより、すべての特徴量が同じ範囲に収まるため、勾配の大きさも均一化されます。これにより、パラメータの更新が均等に行われ、効率的な学習が可能になります。
適切なステップサイズ
スケーリングを行うことで、勾配降下法のステップサイズが適切に設定されるため、収束速度が大幅に改善されます。結果として、最適解に迅速に到達することができます。
4.アルゴリズム特性に与える影響
特徴量スケーリングは、機械学習アルゴリズムの特性にも大きな影響を与えます。特に、距離に基づくアルゴリズムや線形モデルにおいて、その影響は顕著です。ここでは、具体的なアルゴリズムを例に挙げて、特徴量スケーリングがどのようにアルゴリズムの性能を向上させるかを説明します。
(1)距離に基づくアルゴリズム
距離に基づくアルゴリズムは、特徴量間の距離を計算することで予測や分類を行います。以下のアルゴリズムがその代表例です。
k-近傍法(k-NN)
k-近傍法は、データポイント間の距離を計算し、最も近いk個のポイントの多数決や平均値を用いて予測を行います。特徴量のスケールが異なると、大きなスケールを持つ特徴量が距離計算において支配的になり、小さなスケールの特徴量が無視される可能性があります。スケーリングを行うことで、すべての特徴量が同じ範囲で扱われ、距離計算が正確になり、アルゴリズムの性能が向上します。
サポートベクターマシン(SVM)
SVMは、データポイントをクラスに分類するために、特徴量空間における最適なハイパープレーン(超平面)を見つける必要があります。このハイパープレーンを見つけるプロセスでは、データポイント間の距離が重要な役割を果たします。特徴量のスケールが異なると、ハイパープレーンの位置が偏り、分類性能が低下することがあります。スケーリングを行うことで、特徴量間の距離が適切に計算され、最適なハイパープレーンが見つかりやすくなります。
(2)線形モデル
線形モデルも、特徴量スケーリングの影響を受けやすいアルゴリズムの一つです。線形回帰モデルは、特徴量の線形結合を用いてターゲット変数を予測します。特徴量のスケールが異なる場合、モデルの係数(重み)が大きなスケールの特徴量に引きずられることがあります。正確には、大きなスケールの特徴量の係数が小さくなり、逆に小さなスケールの特徴量の係数が大きくなることがあります。これにより、重要な特徴量が過小評価される可能性があります。スケーリングを行うことで、すべての特徴量が同じ基準で評価され、モデルの解釈性が向上します。
(3)クラスタリングアルゴリズム
クラスタリングアルゴリズムも、特徴量スケーリングの影響を受けます。例えば k平均法(k-means 法)は、データポイントをk個のクラスタに分割するアルゴリズムで、データポイント間の距離を最小化するようにクラスタの中心を決定します。特徴量のスケールが異なる場合、大きなスケールの特徴量がクラスタリング結果に過度な影響を与え、小さなスケールの特徴量が無視されることがあります。スケーリングを行うことで、すべての特徴量が同じ範囲で扱われ、クラスタリングの精度が向上します。
5.主な特徴量スケーリング手法
特徴量スケーリングにはさまざまな手法がありますが、ここでは代表的な3つの手法について説明します。
(1)最小最大スケーリング(Min-Max Scaling)
最小最大スケーリングは、特徴量を指定した範囲(通常は[0, 1])に変換する手法です。各特徴量の最小値と最大値を基準にしてスケーリングを行います。
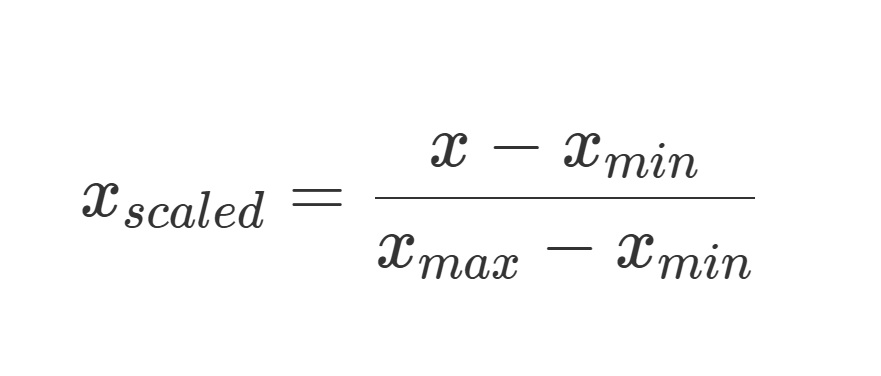
利点
直感的で簡単:スケーリングの計算が直感的で、容易に実装できます。一定の範囲に収める:すべての特徴量が同じ範囲に収まるため、距離計算や勾配降下法に適しています。
欠点
外れ値に敏感:データ中の外れ値が最小値や最大値に影響を与えると、スケーリングが歪む可能性があります。
(2)標準化(Standardization)
標準化は、データを平均0、標準偏差1に変換する手法です。これにより、データの分布が標準正規分布に近づきます。
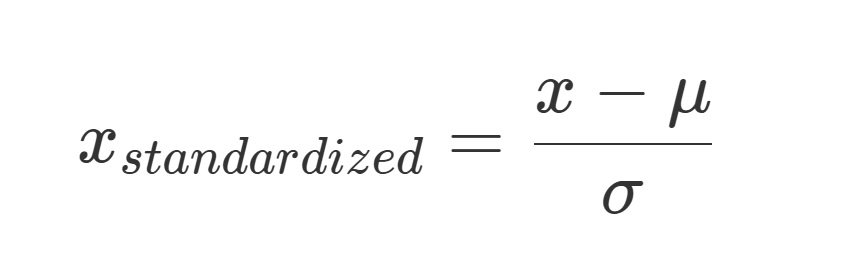
ここで、μは平均値、σは標準偏差です。
利点
- 外れ値に対する耐性:外れ値の影響を受けにくいです。
- 正規分布に近づける:データの分布が標準正規分布に近くなるため、多くのアルゴリズムで性能が向上します。
欠点
- 計算が複雑:平均値と標準偏差の計算が必要なため、最小最大スケーリングよりも計算が複雑です。
(3)ロバストスケーリング(Robust Scaling)
ロバストスケーリングは、データの中央値と四分位範囲(IQR)を基準にしてスケーリングを行います。これにより、外れ値の影響を最小限に抑えることができます。
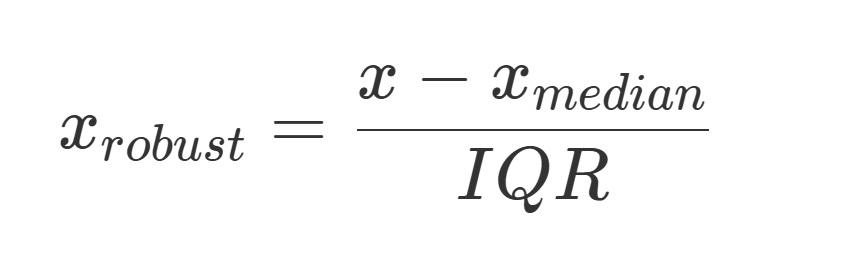
ここで、IQRはデータの第1四分位数(25パーセンタイル)と第3四分位数(75パーセンタイル)の差です。
利点
- 外れ値に強い:外れ値の影響を受けにくいため、外れ値が多いデータに適しています。
欠点
- 計算が複雑:中央値と四分位範囲の計算が必要なため、最小最大スケーリングや標準化よりも計算が複雑です。
事例1:住宅価格予測の成功と失敗
ある都市の住宅価格を予測するプロジェクトに挑戦しているデータサイエンティスト、山田さんのストーリーです。山田さんは、新しいモデルを使って住宅価格を予測しようとしています。利用するモデルはKNN(K-Nearest Neighbors)回帰です。彼はデータセットを集め、面積、部屋数、築年数などの特徴量を含むデータを前処理し、KNN回帰モデル構築にチャレンジしました。
山田さんがKNN回帰を選んだのは、以下の理由からです。
- 非線形な関係を捉える能力: KNN回帰は、線形モデルでは捉えられない複雑な非線形関係を捉えることができます。
- モデルの柔軟性: KNNはパラメトリックでないため、特定の関数形式を仮定せずにデータを扱うことができます。
- シンプルで直感的: KNNはシンプルなアルゴリズムで、データポイントに最も近いK個のデータポイントの平均を取ることで予測を行います。
KNN回帰は、あるデータポイントの周囲に存在するK個の最も近いデータポイントを見つけ、その値の平均を予測値として使用します。これにより、データの局所的な構造を捉えることができ、非線形なパターンにも対応可能です。データセットを学習データとテストデータに分割し、学習データでモデルを構築、構築したモデルをテストデータで検証します。
以下は、その結果です。
- 学習データの誤差:MSE = 150,000
- テストデータの誤差:MSE = 180,000
山田さんは驚きました。「なぜ、こんなに誤差が大きいんだろう?」彼はモデルが期待通りの結果を出していないことに気づきました。山田さんは、まず特徴量のスケールに目を向けました。面積のスケールが非常に大きく、部屋数や築年数と比べて不均一であることに気づきました。この違いがモデルを歪めていると考えました。
山田さんは、最初のアプローチとして最小最大スケーリングを試すことにしました。すべての特徴量を[0, 1]の範囲に変換し、再びKNN回帰モデルを訓練しました。
- 学習データの誤差:MSE = 100,000
- テストデータの誤差:MSE = 120,000
誤差が大幅に減少し、山田さんは喜びました。「これはいい方向に向かっている!」
次に、山田さんは標準化を試してみました。データを平均0、標準偏差1に変換することで、さらに良い結果が得られるのではないかと考えました。
- 学習データの誤差:MSE = 95,000
- テストデータの誤差:MSE = 115,000
標準化によって、誤差はさらに減少しました。山田さんは、自分のアプローチが正しいことを確信し、これからのプロジェクトに自信を持って取り組むことができました。
最終的に、山田さんはKNN回帰モデルが住宅価格予測において有効であることを学びました。特に、特徴量スケーリングがモデルの性能を大幅に向上させることを実感しました。スケーリングを行わない場合、モデルの誤差が大きくなり、予測精度が低下することを身をもって体験しましたが、適切なスケーリング手法を適用することで、問題を解決し、精度を向上させることができました。山田さんは、これからも他のデータサイエンスプロジェクトにおいて特徴量スケーリングを重要なステップとして取り入れることを決意しました。
事例2:顧客クラスタリングの成功と失敗
データサイエンティストの佐藤さんは、顧客データを使ってマーケティング戦略を最適化するためにk-meansクラスタリングを試みていました。このプロジェクトのデータセットには、購入金額、購入回数、年齢などの特徴量が含まれていました。佐藤さんはデータを収集し、前処理を行った後、すぐにk-meansクラスタリングを実行しました。しかし、結果は予想外のものでした。
- クラスタリング結果:いくつかの大きなクラスタと、それに比べて小さなクラスタが形成された。
- 問題点:大部分の顧客が大きなクラスタに集中し、セグメンテーションがうまく行っていない。
佐藤さんは困惑しました。「なぜ、こんなにバランスが悪いんだろう?」彼は結果を再検討し、問題の原因を探り始めました。データを詳細に分析していると、佐藤さんは特徴量のスケールが非常に異なることに気づきました。購入金額のスケールが他の特徴量に比べて非常に大きく、その影響でクラスタリング結果が歪んでいたのです。佐藤さんは、まず標準化を試みることにしました。すべての特徴量を平均0、標準偏差1に変換し、再びk-meansクラスタリングを実行しました。
- クラスタリング結果:クラスタのバランスが改善され、異なるセグメントが明確に分離された。
- 結果の精度:顧客セグメンテーションがより正確になり、マーケティング戦略の最適化に役立つ結果が得られた。
佐藤さんは標準化の効果に驚きました。さらに、外れ値の影響を最小限に抑えるために、佐藤さんはロバストスケーリングも試してみました。データの中央値と四分位範囲を基準にしてスケーリングを行い、再度k-meansクラスタリングを実行しました。
- クラスタリング結果:外れ値の影響が減少し、クラスタリングの精度がさらに向上した。
- 結果の精度:セグメンテーションがさらに細分化され、マーケティング施策においてターゲットをより明確に設定することができた。
最終的に、佐藤さんは特徴量スケーリングが顧客クラスタリングにおいて非常に重要であることを学びました。スケーリングを行わない場合、購入金額のような大きなスケールの特徴量がクラスタリング結果に過度に影響を与え、正確なセグメンテーションが難しくなることを実感しました。しかし、適切なスケーリング手法を適用することで、クラスタリングの精度が向上し、マーケティング戦略の最適化に成功しました。佐藤さんは、今後のプロジェクトにおいても特徴量スケーリングを重要なステップとして取り入れることを決意しました。
6.データリーク問題
(1)データのリーク
特徴量スケーリングを行う際には、データのリーク(Data Leakage)を防ぐことが重要です。データのリークとは、学習データとテストデータの間で情報が漏れてしまい、テストデータの予測性能が実際以上に高く見積もられてしまう現象です。これを防ぐためには、以下の点に注意する必要があります。
訓練データとテストデータを分割してからスケーリングを行う
データセット全体に対してスケーリングを行うのではなく、まず学習データとテストデータを分割し、それぞれに対して個別にスケーリングを適用します。これにより、学習データの情報がテストデータに漏れないようにします。
クロスバリデーションにおけるスケーリング
クロスバリデーションを使用する場合、各分割の学習データセットに対してスケーリングを行い、そのスケーリングパラメータ(平均値や標準偏差など)をテストデータセットに適用します。これにより、データのリークを防ぎつつ、モデルの性能を正確に評価することができます。
(2)学習データとテストデータに対するスケーリングの適用方法
特徴量スケーリングを正しく行うための具体的な手順を以下に示します。
Step 1 データの分割
データセットを学習データとテストデータに分割します。例えば、80%を訓練データ、20%をテストデータとします。
Step 2 学習データのスケーリング
学習データに対してスケーリングを適用します。このとき、学習データの平均値や標準偏差を計算し、それを用いてスケーリングを行います。
Step 3 スケーリングパラメータの保存
学習データで計算した平均値や標準偏差、または最小値や最大値などのスケーリングパラメータを保存します。
Step 4 テストデータのスケーリング
学習データで計算したスケーリングパラメータを使用して、テストデータをスケーリングします。これにより、学習データとテストデータのスケールが一致し、モデルの評価が正確になります。
(3)ベストプラクティス
以下のベストプラクティスを守ることで、特徴量スケーリングを効果的に行うことができます。
一貫性のあるスケーリング
学習データとテストデータに対して同じスケーリングパラメータを使用することで、一貫性を保ちます。
外れ値の処理
スケーリングを行う前に、外れ値を検出し適切に処理することで、スケーリングの効果を最大限に引き出します。
アルゴリズムに適したスケーリング手法の選択
使用する機械学習アルゴリズムに応じて、最適なスケーリング手法(例えば、標準化、最小最大スケーリング、ロバストスケーリングなど)を選択します。
スケーリングの適用タイミング
データパイプラインの一環としてスケーリングを組み込み、学習データとテストデータの両方で一貫した処理を行います。
7.今回のまとめ
今回は、「機械学習における特徴量スケーリングの重要性と手法」というお話しをしました。特徴量スケーリングは、機械学習モデルの精度と計算効率を向上させるための重要なステップです。主なスケーリング手法には、最小最大スケーリング、標準化、ロバストスケーリングがあります。これらを適切に適用することで、モデルの性能が大幅に向上します。スケーリングを行う際には、データのリークを防ぎ、一貫性のある方法を用いることが重要です。特徴量スケーリングを取り入れることで、より精度の高い機械学習モデルを構築し、実践的な問題解決に役立ててください。